Cardinalidade, em banco de dados, está ligado as relações entre suas tabelas e quantos dados de uma entidade (tabela) estão presentes na outra entidade.
Da matemática o conceito de cardinalidade, de modo simples, vem de elementos de um determinado conjunto que estão em outro conjunto.
Exemplo:
Dados os conjuntos A = {1,2,3,4,5} e B = {1,3,5}
Podemos afirmar que o conjunto de B é um subconjunto de A. Podemos afirmar também que B está contido em A ou que A contém B. Podemos assim concluir que A e B tem uma relação.
Se você entendeu esse conceito, imagine agora um banco de dados com esses conjuntos A e B, sendo eles entidades (tabelas) do banco de dados e seus números A = {1,2,3,4,5} e B = {1,3,5} são considerados como os atributos do banco de dados.
Simplificando ainda mais:
Ao invés de A vamos substituir por um conjunto chamado Clientes e ao invés de {1,2,3,4,5} vamos usar os atributos {Código,Nome,Sobrenome,Idade,CPF}.
Agora da mesma forma substituiremos B pela entidade Identificação_Clientes e seus atributos serão derivados de Clientes, sendo: {Código,Sobrenome,CPF}
Nesse exemplo temos a entidade Identificação_Clientes sendo derivada de atributos da entidade Clientes.
Na matemática esses conjuntos A = {1,2,3,4,5} e B = {1,3,5} são considerados como uma Função Injetora, pois todos os elementos de B (domínio) se relacionam com um elemento de A (contra domínio).
Na matemática temos 3 tipos de função:
Função Injetora: todos os elementos do domínio se relacionam com apenas um elemento do contra domínio, podendo sobrar elementos no domínio.
Função Sobrejetora: todos os elementos do contra domínio se relacionam a um elemento do domínio.
Função Bijetora: a função é ao mesmo tempo injetora e sobrejetora. Ou seja, tem a quantidade de elementos iguais e todos se relacionam.
Tipos de relacionamento
Ao criar um relacionamento entre tabelas de um banco de dados podemos utilizar das cardinalidades:
1:1: um-para-um; o mais simples do relacionamentos o relacionamento de A para B permite apenas 1 valor de A para 1 de B.
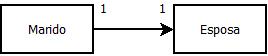
1:N: um-para-muitos; 1 valor de A se relaciona com muitos de B.
N:1: muitos-para-um; muitos valores de A se relacionam com 1 de B. Observe que apenas mudamos o ponto de vista. a relação é a mesma da anterior.
Obs.: na cardinalidade 1:N e N:1 a chave primária (Primary Key) da entidade é levada do UM para o N. Observe as setas. (Se você não sabe oque é uma chave primária, entre aqui).
N:N: muitos-para-muitos; muitos valores de A se relacionam com muitos de B. Neste caso há a necessidade do uso de outra entidade (tabela), chamamos isso de entidade associativa.
Mostrando postagens com marcador Primary key. Mostrar todas as postagens
terça-feira, 2 de abril de 2013
terça-feira, 19 de fevereiro de 2013
Chave Primária (Primary Key)
Nos SGBD podemos definir um determinado campo de uma tabela como chave primária (primary key), a chave primaria indica que este campo nunca poderá se repetir. Dessa forma podemos usar este campo como índice para o restante dos campos da tabela.
Esses campos são utilizados quase sempre como um identificador. Tornando as consultas realizadas mais simples de serem filtradas, usando este identificador como parâmetro.
Exemplo:
Na tabela acima o campo "fun_codigo" é único para qualquer cliente, podemos definir então este campo como uma chave primária.
Para definir este campo como uma chave primária devemos utilizar o parâmetro primary key () informando dentro do parenteses o nome do campo que será a chave primária.
Então, o comando SQL completo para se montar a tabela acima seria:
Agora utilizando o comando describe funcionarios; observe as características da tabela:
Esses campos são utilizados quase sempre como um identificador. Tornando as consultas realizadas mais simples de serem filtradas, usando este identificador como parâmetro.
Exemplo:
fun_codigo
|
fun_nome
|
fun_endereco
|
fun_cidade
|
1
|
George Wurthmann
|
Rua Um
|
Campinas
|
2
|
Kerolen Catarina
|
Rua Dois
|
São Paulo
|
3
|
João Silva
|
Rua Três
|
Hortolândia
|
Na tabela acima o campo "fun_codigo" é único para qualquer cliente, podemos definir então este campo como uma chave primária.
Para definir este campo como uma chave primária devemos utilizar o parâmetro primary key () informando dentro do parenteses o nome do campo que será a chave primária.
Então, o comando SQL completo para se montar a tabela acima seria:
create table funcionarios ( fun_codigo integer not null, fun_nome varchar(30) not null, fun_endereco varchar(20) not null, fun_cidade varchar(15) not null, primary key (fun_codigo) );O parâmetro not null que inseri a frente de todos os campos impede que o campo seja aceito vazio (nulo), importante para impedir que o usuário de determinado sistema omita campos importantes.
Agora utilizando o comando describe funcionarios; observe as características da tabela:
Observamos que o campo fun_codigo tem agora o status "PRI" dentro da coluna "Key" identificando-o como a chave primária da tabela. Podemos observar ainda na coluna "Null" todos os campos com o status "NO" indicando que esses campos não podem ser nulos.
segunda-feira, 21 de janeiro de 2013
Alterar valores das tabelas
Drop
Drop é o comando utilizado para eliminar uma tabela inteira de seus banco de dados, então utilize-a com cuidado.
Exemplo:
Alter
Com o comando Alter podemos inserir novas colunas em nossas tabelas já existentes e também modifica-las ou excluí-las.
Inserir coluna:
Obs.: em outros SGBD os comandos para inserir, modificar e excluir podem ser diferente.
Describe
Este comando nos da a descrição de todas as colunas da tabela:
Update
O update altera os valores de um determinado registro ou coluna.
Exemplo:
Para alterarmos apenas um desses valores devemos usar a clausula WHERE.
Exemplo:
Delete
Com o comando delete podemos excluir registros de uma tabela.
Exemplo:
Drop é o comando utilizado para eliminar uma tabela inteira de seus banco de dados, então utilize-a com cuidado.
Exemplo:
DROP table funcionarios;
Alter
Com o comando Alter podemos inserir novas colunas em nossas tabelas já existentes e também modifica-las ou excluí-las.
Inserir coluna:
ALTER table funcionarios ADD fun_cep varchar(8);Alterar coluna:
ALTER table funcionarios modify fun_cep varchar(9);Excluir coluna:
ALTER table funcionarios DROP fun_cep;
Obs.: em outros SGBD os comandos para inserir, modificar e excluir podem ser diferente.
Describe
Este comando nos da a descrição de todas as colunas da tabela:
describe clientes;Na imagem acima podemos observar o resultado: é mostrada uma tabela que informa, respectivamente, todos os nossos campos, os tipos dos campos, se podem ser nulos (vazio), se são chave primária, e extra (outras características).
Update
O update altera os valores de um determinado registro ou coluna.
Exemplo:
UPDATE clientes SET cli_estado = "SP";Neste exemplo acima todos os registros da coluna cli_estado são alterados para "SP".
Para alterarmos apenas um desses valores devemos usar a clausula WHERE.
Exemplo:
UPDATE clientes SET cli_estado = "SP" WHERE cli_codigo = 1;Neste segundo exemplo definimos que será alterado para "SP" apenas o registro em que o cli_codigo for 1.
Delete
Com o comando delete podemos excluir registros de uma tabela.
Exemplo:
DELETE from clientes;Essa é a forma mais simples de se usar, e todos os registros da tabela são excluídos. Porém, podemos usar com o DELETE a clausula WHERE da mesma forma que usamos no exemplo do UPDATE:
DELETE from clientes WHERE cli_codigo = 1;
Assinar:
Postagens (Atom)


